تصور کنید شبکه قبل از کاربران اختلال را تشخیص دهد، علت احتمالی را پیدا کند و برای رفع آن اقدام کند؛ این ایده اصلی Self-Healing Networks یا شبکههای خودترمیمشونده است.
اهمیت این موضوع فقط به سادهتر شدن کار تیم شبکه محدود نمیشود. گزارش Annual Outage Analysis 2025 مؤسسه Uptime Institute نشان میدهد ۵۴ درصد از پاسخدهندگانی که یک قطعی مهم را تجربه کردهاند، هزینه آخرین قطعی آنها بیش از ۱۰۰ هزار دلار بوده و برای یکپنجم، این هزینه از یک میلیون دلار عبور کرده است.
در این مقاله از نت وی پرایم با مفهوم Self-Healing Network و مزایا و محدودیت های آن آشنا خواهید شد.
Self-Healing Network چیست؟
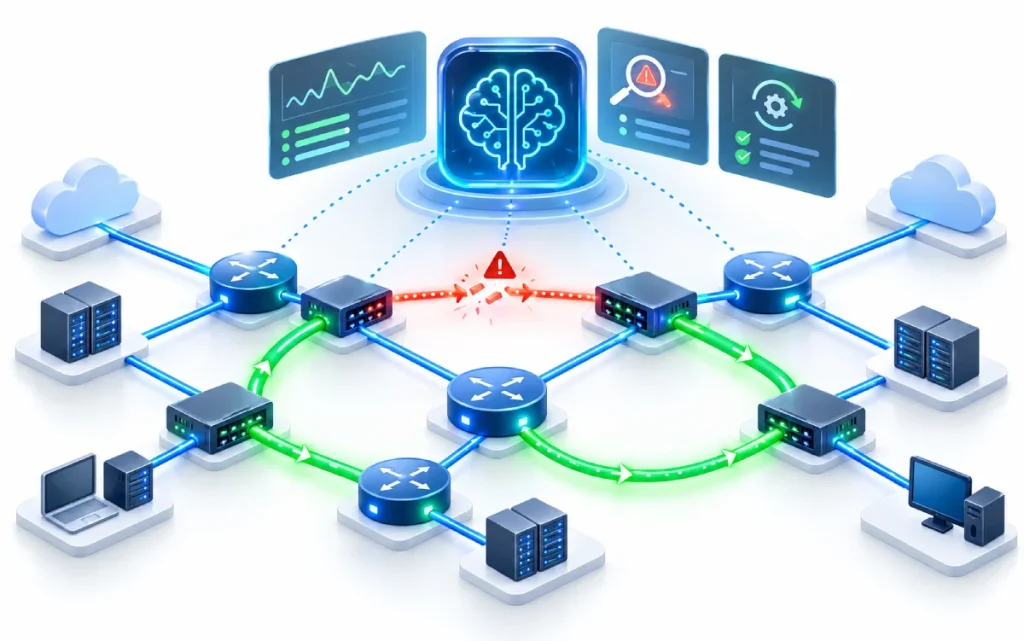
شبکه خودترمیمشونده یا Self-Healing Network، شبکهایست که میتواند بعضی از مشکلات را خودش تشخیص دهد و برای رفع آنها اقدام کند. یعنی بهجای اینکه همیشه منتظر بررسی و دخالت مدیر شبکه بماند، وضعیت شبکه را زیر نظر میگیرد، مشکل را پیدا میکند و در صورت داشتن مجوز، اقدام مناسب را انجام میدهد.
بعد از آن هم دوباره وضعیت شبکه را بررسی میکند تا مطمئن شود مشکل برطرف شده است. هوش مصنوعی و اتوماسیون کمک میکنند این فرایند سریعتر و با دخالت دستی کمتر انجام شود.
با افزایش استفاده از هوش مصنوعی در مانیتورینگ، عیبیابی و Self-Healing Networks، این سؤال جدیتر میشود که آیا هوش مصنوعی جای مهندس شبکه را میگیرد؟ یا فقط نقش او را به سمت تصمیمگیری و طراحی پیشرفتهتر تغییر میدهد.
Self-Healing به معنی حذف کنترل انسانی نیست؛ اقدامات خودکار باید در محدوده Policyها و سطح دسترسی مشخص انجام شوند.
مثال: اگر یک Uplink دچار افت کیفیت یا قطعی شود، سیستم میتواند مشکل را تشخیص دهد، ترافیک را به مسیر سالم منتقل کرده و سپس بررسی کند که ارتباط کاربران به حالت عادی برگشته است.
مزایا و محدودیتهای شبکه خودترمیمشونده
| مزایا | محدودیت ها |
|---|---|
| تشخیص سریعتر اختلالها | وابستگی زیاد به کیفیت Telemetry و Logها |
| کاهش زمان رفع مشکل یا MTTR | همه مشکلات قابل این را ندارند که خودکار شوند |
| کاهش کارهای تکراری تیم شبکه | احتمال اجرای Action اشتباه در صورت تشخیص نادرست |
| امکان واکنش خودکار به برخی Incidentها | نیاز به Policy، Permission و Rollback دقیق |
| بررسی نتیجه تغییر پس از اجرا | پیچیدگی بیشتر در شبکههای Multi-Vendor |
| افزایش پایداری و کاهش مدت اختلال | نیاز به نظارت انسانی برای تغییرات حساس |
چرا قطعی شبکه اینقدر گران تمام میشود؟
آمار Uptime Institute نشان میدهد اختلال در زیرساختهای دیجیتال میتواند هزینه سنگینی برای سازمانها داشته باشد:
- طبق گزارش Annual Outage Analysis مؤسسه Uptime Institute در سال ۲۰۲۶، ۵۷ درصد از پاسخدهندگان اعلام کردهاند هزینه آخرین قطعی بزرگ آنها بیش از ۱۰۰ هزار دلار بوده است.
- در گزارش ۲۰۲۵، از هر پنج پاسخدهنده یک نفر هزینه آخرین قطعی مهم خود را بیش از یک میلیون دلار اعلام کرده است.
- در گزارش ۲۰۲۴ نیز چهار نفر از هر پنج پاسخدهنده معتقد بودند آخرین قطعی جدی آنها با مدیریت، فرایند یا پیکربندی بهتر قابل پیشگیری بوده است.
این آمارها مربوط به قطعیهای زیرساخت IT و دیتاسنتر هستند، نه فقط شبکه؛ اما نشان میدهند تشخیص سریعتر مشکل، فرایندهای بهتر و واکنش خودکار میتوانند نقش مهمی در کاهش ریسک و مدت اختلال داشته باشند.
شبکه Self-Healing چگونه کار میکند؟
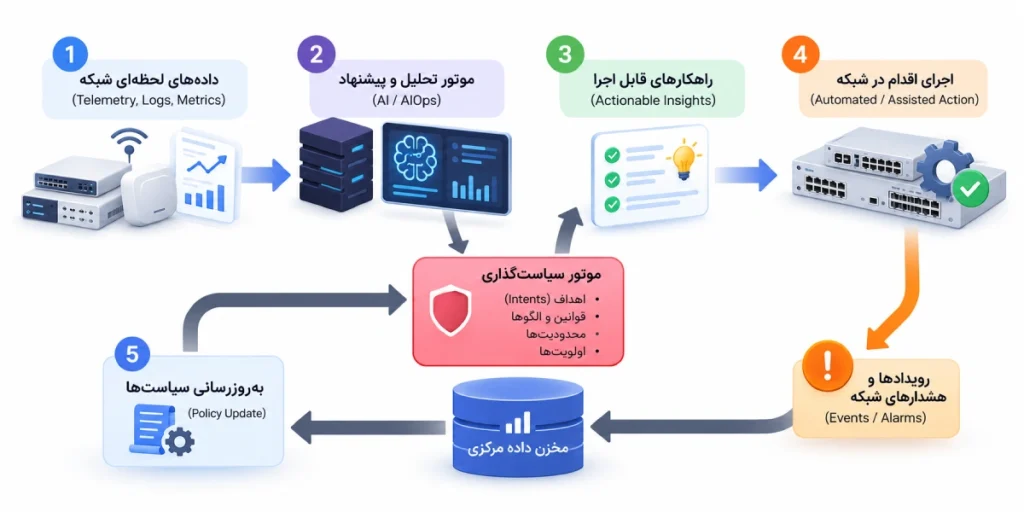
شبکه Self-Healing بر پایه Closed-Loop Automation کار میکند؛ یعنی فقط مشکل را شناسایی و اصلاح نمیکند، بلکه نتیجه تغییر را هم بررسی میکند. این فرایند شامل چند مرحله است:
- جمعآوری داده: دریافت Telemetry، Log و شاخصهایی مثل Latency و Packet Loss
- تشخیص ناهنجاری: شناسایی رفتار غیرعادی در شبکه
- تحلیل علت: پیدا کردن Root Cause بهجای بررسی جداگانه Alertها
- اصلاح: پیشنهاد یا اجرای اقدام مناسب براساس Policy
- Validation: بررسی دوباره شبکه برای اطمینان از رفع مشکل
تفاوت اصلی Self-Healing با Automation ساده همین مرحله آخر است؛ سیستم باید بتواند نتیجه اقدام خود را هم ارزیابی کند.
هوش مصنوعی چه نقشی در Self-Healing Networks دارد؟
هوش مصنوعی در شبکههای Self-Healing بیشتر برای تحلیل دادههای حجیم، تشخیص ناهنجاریها، ارتباط دادن Alertها و پیدا کردن علت اصلی مشکل استفاده میشود. همین رویکرد در دیتاسنترها هم کاربرد زیادی دارد؛ جایی که هوش مصنوعی در دیتاسنترها میتواند به پایش زیرساخت، تحلیل مصرف منابع، تشخیص ناهنجاریها و واکنش سریعتر به اختلالات کمک کند.
بعد از تشخیص مشکل، سیستم میتواند براساس Policy مشخص، راهکار پیشنهاد دهد یا در برخی سناریوها اقدام اصلاحی را اجرا کند. در این مسیر، هوش مصنوعی عاملی (Agentic AI) میتواند فراتر از تحلیل داده عمل کند و برای رسیدن به یک هدف مشخص، چند مرحله از تحلیل، تصمیمگیری و اجرای اقدام را بهصورت هماهنگ انجام دهد.
اگر بخواهیم خیلی خلاصه بگوییم؛ Telemetry + AI/AIOps + Automation + Validation = Self-Healing
هوش مصنوعی علاوه بر کمک به تشخیص و رفع خودکار اختلالات در Self-Healing Network، در حوزه امنیت هم برای شناسایی تهدیدها، تحلیل رفتارهای مشکوک و واکنش سریعتر به حملات کاربرد دارد؛ موضوعی که در مقاله نقش هوش مصنوعی در امنیت شبکه بیشتر بررسی کردهایم.
آیا باید تمام تغییرات شبکه را به AI سپرد؟
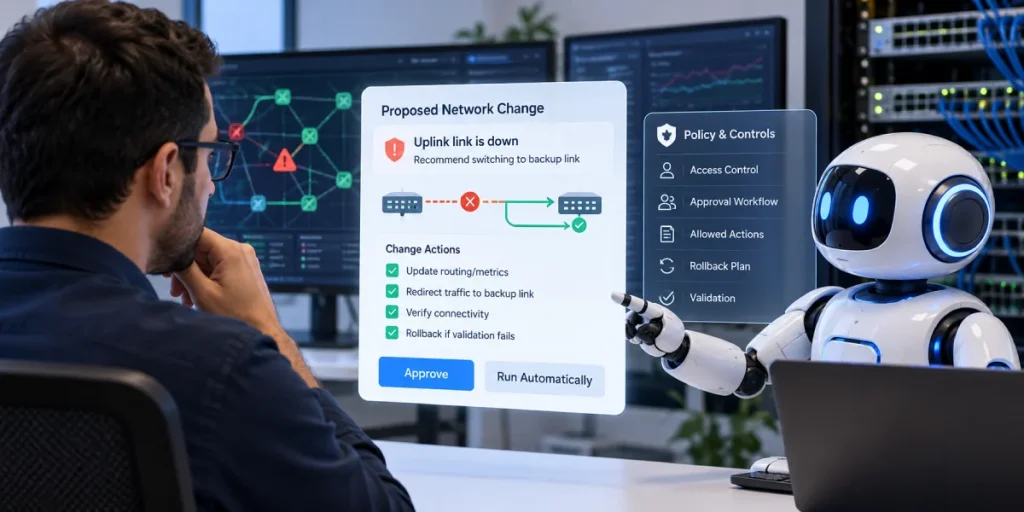
خیر. در Self-Healing، هر اقدام خودکار باید در محدوده مشخصی از Policy، دسترسی، تأیید، Rollback و Validation انجام شود.
به همین دلیل، سیستمهای حرفهای بین «پیشنهاد اقدام» و «اجرای خودکار» تفاوت قائل میشوند. هدف این نیست که AI هر تغییری را خودش انجام دهد؛ بلکه فقط اقداماتی را اجرا کند که از قبل مجاز و کنترلشده هستند.
توصیه تیم نتویپرایم؛ از کجا شروع کنیم؟
یکی از اشتباهات رایج در پیادهسازی Self-Healing این است که از همان ابتدا بخواهیم «همهچیز» را خودکار کنیم. رویکردی که ما توصیه میکنیم، مرحلهای است:
۱. اول Visibility، بعد Automation
قبل از هر نوع خودکارسازی، باید مطمئن شوید Telemetry، Logها و دادههای عملکرد شبکه دقیق و قابل اعتماد هستند. بدون داده درست، تصمیم خودکار هم قابل اعتماد نخواهد بود.
۲. از یک مشکل پرتکرار شروع کنید
مشکلی را انتخاب کنید که تیم شبکه مرتب بهصورت دستی رفع میکند؛ مثل Port Flap، Configuration Drift یا Missing VLAN. این سناریوها برای شروع Automation مناسبتر از تغییرات حساس و گسترده هستند.
۳. ابتدا Human-in-the-Loop باشید
در مراحل اول، سیستم مشکل را تشخیص دهد و راهکار پیشنهاد کند، اما اجرای تغییر با تایید مهندس شبکه انجام شود. بعد از اطمینان از دقت و پایداری سیستم، میتوان بعضی اقدامات کمریسک را خودکار کرد.
۴. نتیجه را اندازه بگیرید
قبل و بعد از Automation شاخصهایی مثل MTTR، تعداد Incidentهای تکراری و میزان دخالت دستی تیم را مقایسه کنید. اگر تغییری قابل اندازهگیری ایجاد نشده، Automation هنوز ارزش عملی لازم را ایجاد نکرده است.
جمع بندی
Self-Healing Networks با ترکیب Telemetry، هوش مصنوعی و Automation تلاش میکنند مشکلات شبکه را سریعتر شناسایی کنند، علت آنها را پیدا کنند و در شرایط مشخص، اقدام اصلاحی انجام دهند. تفاوت مهم این رویکرد با اتوماسیون ساده، بررسی نتیجه تغییر و اطمینان از رفع مشکل است.
با این حال، هدف Self-Healing حذف مهندس شبکه نیست؛ بلکه کاهش کارهای تکراری و کوتاهتر کردن زمان تشخیص و رفع اختلال است. بهترین مسیر نیز شروع از سناریوهای کمریسک، استفاده از دادههای قابل اعتماد و افزایش تدریجی سطح Automation است.
سوالات متداول شبکه خودترمیمی، Self-Healing Network
1. تفاوت Self-Healing Network و AIOps چیست؟
AIOps بیشتر روی تحلیل داده، تشخیص ناهنجاری و Root Cause Analysis تمرکز دارد. Self-Healing زمانی شکل میگیرد که این تحلیل به Automation وصل شود و سیستم بتواند اقدام اصلاحی انجام دهد و نتیجه آن را هم بررسی کند.
2. آیا Self-Healing Network بدون AI قابل پیادهسازی است؟
بله. برای سناریوهای ساده و مشخص میتوان از Rule و Automation استفاده کرد؛ مثلاً در صورت Down شدن یک لینک، ترافیک به مسیر جایگزین منتقل شود. AI زمانی مهمتر میشود که حجم داده زیاد باشد یا تشخیص علت مشکل پیچیده باشد.
3. آیا Self-Healing Networks فقط برای شبکههای بزرگ مناسب هستند؟
خیر. در شبکههای کوچک هم میتوان از آن استفاده کرد، اما بیشترین ارزش آن در محیطهایی با تعداد زیاد Device، Site، Alert و Incident دیده میشود؛ جایی که بررسی دستی مشکلات زمانبر است.
4. برای پیادهسازی Self-Healing Network به چه زیرساختی نیاز داریم؟
معمولاً به Telemetry مناسب، سیستم Monitoring یا Assurance، Automation Platform، Policyهای مشخص و دسترسی کنترلشده به تجهیزات شبکه نیاز است.